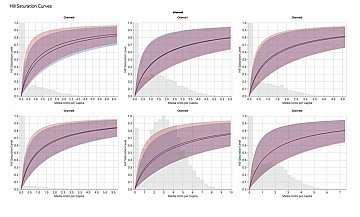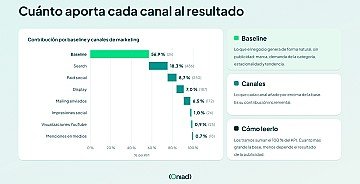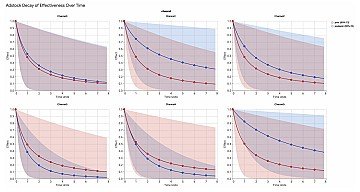
En los artículos anteriores hemos ido montando las piezas del Marketing Mix Modeling. Vimos cómo el adstock reparte el efecto de la publicidad en el tiempo, cómo la saturación explica que cada euro adicional rinda menos, y cómo la descomposición de la serie temporal permite separar el baseline del incremental. Lo que no hemos contado todavía es qué entra realmente en el modelo.
Un MMM no es un algoritmo sofisticado que encuentra la verdad por sí solo: es un modelo que explica la evolución de las ventas a partir de las variables que le proporcionamos. Lo que no esté dentro, simplemente no existe para él. Y aquí está el problema: el efecto de una variable ausente no desaparece, se reparte entre las que sí están, normalmente entre las que más se le parecen. Así es como un canal acaba llevándose el crédito de una promoción, de un pico estacional o de un competidor que dejó de invertir.
Por eso la selección de variables es un ejercicio de criterio, no de recopilación. En este artículo repasamos los cuatro grandes bloques que debería contemplar cualquier MMM bien construido: los medios de pago, los medios orgánicos, las acciones no publicitarias y las variables de control.
Antes de comenzar: granularidad y horizonte temporal
Una condición previa que afecta a las cuatro familias de variables: en un MMM los datos se recogen y se modelan habitualmente con granularidad semanal, no diaria.
El motivo es que el dato diario incorpora mucho ruido que no aporta información sobre la eficacia de los medios: el patrón de día de la semana, los desfases entre el impacto y la conversión, los efectos de arrastre que reparten el resultado de una impresión entre varios días. Si el adstock nos enseñó que el efecto de un anuncio se extiende en el tiempo, pretender aislar lo que ocurrió un martes concreto es forzar al modelo a explicar variaciones que no tienen causa publicitaria.
La agregación semanal suaviza ese ruido, se alinea con el ciclo natural de planificación de medios y permite que las transformaciones de adstock y saturación trabajen sobre series más estables. Tiene un coste que conviene asumir desde el principio: cada semana es una observación, así que un modelo necesita entre dos y tres años de histórico para contar con suficientes puntos y capturar al menos dos ciclos estacionales completos.
Medios de pago
Es el bloque más evidente y el que motiva la construcción del modelo: toda la inversión publicitaria que el anunciante controla y sobre la que quiere decidir. Programática, Google Ads, Meta, televisión, radio, exterior, afiliación de pago, native. Cada canal entra como una variable propia. Podríamos agrupar canales si la inversión en ellos fuera reducida y la naturaleza del canal similar.
A estas variables se les aplican las transformaciones que vimos en artículos anteriores: primero el adstock, para repartir su efecto en el tiempo, y después la saturación, para reflejar que cada euro adicional rinde menos. Su particularidad frente al resto de bloques es que llevan una inversión asociada, y eso es lo que permite calcular no solo su contribución a las ventas, sino también su retorno: el iROAS de cada canal y el mROAS.
Qué métrica usar para cada canal
En realidad no se elige entre inversión y exposición: se usan ambas. La variable de exposición, habitualmente impresiones, es la que entra en el modelo y recibe las transformaciones, porque lo que genera el efecto no es el dinero en sí, sino el volumen de impactos que ese dinero compra. La inversión se mantiene en paralelo, asociada a cada canal, para traducir después la contribución estimada en retorno.
Que ambas convivan no es una redundancia, es lo que evita confundir un cambio de precio con un cambio de eficacia. Si el CPM de un canal sube un 40% de un trimestre a otro, la misma inversión compra muchas menos impresiones; usando solo la inversión, el modelo leería esa caída de exposición como una pérdida de eficacia del canal.
La elección de la métrica de exposición depende del medio. En display, vídeo o televisión, las impresiones son la referencia natural. En search, sin embargo, es habitual trabajar con clics en lugar de impresiones: la impresión de un anuncio de búsqueda depende en gran medida de dinámicas de subasta y de concordancias amplias que poco tienen que ver con la exposición real del usuario al mensaje, mientras que el clic refleja mejor el impacto efectivo del canal.
Con qué nivel de detalle separar los canales
Cuanto más desagregamos, más preguntas puede responder el modelo: no es lo mismo saber qué aporta la programática como bloque que distinguir entre prospección, retargeting y vídeo, que tienen comportamientos de adstock y saturación muy diferentes. Pero cada variable adicional necesita suficiente variación histórica para estimarse con fiabilidad. Desagregar un canal pequeño en cinco subcanales no produce cinco respuestas: produce cinco estimaciones poco fiables. El criterio sensato es separar hasta donde el volumen de inversión y la historia disponible lo permitan. Por eso, en este tipo de modelos trabajamos principalmente a nivel de canal agregado y no de campaña.
Medios orgánicos
El segundo bloque recoge la actividad de medios que genera exposición sin una inversión publicitaria detrás. La clave está precisamente ahí: igual que un medio de pago, un medio orgánico entra en el modelo a través de su métrica de exposición. Las impresiones o el alcance de las publicaciones orgánicas en redes sociales, las visualizaciones de los vídeos en YouTube, el número de emails enviados a la base de datos propia, las notificaciones push de la app.
Técnicamente se tratan igual que los medios de pago: reciben sus propias transformaciones de adstock y saturación, porque su efecto también se arrastra en el tiempo y también se satura. Una newsletter enviada hoy sigue generando visitas durante días, y duplicar la frecuencia de envío no duplica las ventas. La única diferencia real es que, al no llevar una inversión asociada, de ellos se obtiene su contribución a las ventas, pero no un retorno comparable al de los canales de pago. Igualmente, el modelo calculará su efecto causal, que se obtendrá diferenciando entre el resultado real y un escenario ficticio donde ese canal tuvo una actividad cero.
La pregunta razonable es por qué incluirlos si no se van a optimizar como una línea de presupuesto. Y la respuesta conecta con la idea que abría el artículo: lo que no está en el modelo no desaparece, se reparte entre lo que sí está. Si la actividad orgánica no entra como variable, su efecto acaba absorbido por el baseline, infravalorando el trabajo que realmente hace, o, lo que es peor, repartido entre los canales de pago que se mueven en paralelo. Y lo orgánico y lo pagado se mueven en paralelo constantemente: un lanzamiento activa a la vez el envío de newsletter, la publicación orgánica y la inversión en display, de modo que el modelo necesita las tres variables para poder separar qué hizo cada una.
Acciones no publicitarias
El tercer bloque recoge decisiones de negocio que afectan directamente a las ventas sin ser publicidad, pero que son intervenibles por nosotros: promociones y descuentos, cambios de precio, lanzamientos de producto, aperturas de tienda o cambios en la distribución, cambios en los gastos de envío o en la política de devoluciones.
Son variables que no tienen una métrica de exposición ni una lógica de arrastre comparable a la de un medio, así que entran en el modelo de forma más directa: un descuento como el porcentaje aplicado o el precio medio del periodo, una promoción o un lanzamiento como una variable que marca las semanas en que estuvo activo. Lo relevante es que el modelo sí estima su contribución y su efecto incremental: cuánto de las ventas se debe a ellas y no a los medios.
Y ahí está el motivo por el que no pueden quedarse fuera. Este tipo de acciones suelen coincidir en el tiempo con los picos de inversión publicitaria, porque es exactamente lo que hace un buen plan de marketing: se concentra el presupuesto en el lanzamiento, en el Black Friday, en la campaña de rebajas. Si el modelo no sabe que esas semanas hubo un 30% de descuento, atribuirá el pico de ventas a lo único que ve moverse: los medios. El canal se lleva un crédito que era del precio.
El caso inverso es igual de problemático. Una rotura de stock o una subida de precio pueden hundir las ventas en pleno periodo de inversión alta, y sin esa variable el modelo concluirá que el canal dejó de funcionar. No dejó de funcionar: no había producto que vender.
Variables de control
El cuarto bloque no recoge acciones del anunciante, sino el contexto en el que ocurren las ventas: todo aquello que influye en el resultado pero que no se controla desde el plan de marketing. Estacionalidad, festivos, inversión de la competencia, situación macroeconómica, clima, eventos deportivos, cambios regulatorios. El modelo no nos reportará un resultado de contribución o incremento causal de estas variables, ya que toda su información se concentrará dentro del baseline.
Su función es distinta a la del resto de bloques. No se incluyen para medir su retorno ni para optimizarlas, sino para evitar que su efecto se atribuya erróneamente a los medios. Pero no todas las variables de contexto cumplen el mismo papel, y meterlas todas en el mismo saco es uno de los errores más caros en la construcción de un MMM. Conviene distinguir tres tipos.
Confusores: los que hay que incluir sí o sí
Un confusor es una variable que influye a la vez en la inversión publicitaria y en las ventas. La estacionalidad es el ejemplo perfecto: en diciembre se vende más, y en diciembre también se invierte más. Las dos series suben a la vez, y si el modelo no sabe que existe la Navidad, interpretará que fue la inversión la que causó el pico.
Lo mismo ocurre con la actividad de la competencia (si un competidor desaparece del mercado, nuestras ventas suben sin que hayamos hecho nada), con el ciclo económico o con la presión promocional del sector. Omitir un confusor no resta precisión al modelo, sino que genera un sesgo sistemático en la contribución estimada de los canales que se mueven en paralelo a él. Son, por tanto, las variables de control más importantes y las primeras que hay que identificar.
Predictores: los que conviene incluir
Un predictor influye en las ventas, pero no en la decisión de inversión. El clima es el caso típico en muchas categorías: una ola de calor dispara las ventas de ciertos productos, pero nadie planificó el presupuesto en función de la previsión meteorológica. Lo mismo con un evento deportivo puntual o con un día festivo local.
Como no afectan a la inversión, omitirlos no sesga la estimación de los canales. Lo que hacen es explicar variación que de otro modo quedaría como ruido, y eso mejora la precisión del modelo y estrecha los intervalos de credibilidad.
Mediadores: los que no se deben incluir
Aquí está el error más contraintuitivo y el más costoso. Un mediador es una variable que se sitúa en medio del camino causal entre el marketing y la venta: no es una causa externa, sino un paso intermedio del propio efecto que queremos medir.
El ejemplo más claro afecta directamente a la programática y al branding. Una campaña de display genera notoriedad, esa notoriedad provoca que el usuario busque la marca por su nombre, y esa búsqueda acaba en una compra. Las búsquedas de marca no son una causa externa de la venta: son el resultado intermedio de la campaña. Lo mismo ocurre con el tráfico directo a la web, con las visitas al sitio o con las descargas de la app.
¿Qué pasa si incluimos las búsquedas de marca como variable de control? Que el modelo atribuirá a esa variable el efecto que en realidad generó la campaña que las provocó. El canal aparecerá con una contribución mucho menor de la real, no porque no funcione, sino porque le hemos quitado del camino la parte de su efecto que viajaba por ahí.
Es un error especialmente dañino para los canales de generación de demanda, que son precisamente los que actúan a través de mediadores: la programática, el vídeo, la televisión, todo lo que trabaja en la parte alta del embudo. Los canales de captura de demanda, que convierten de forma directa, apenas se ven afectados. El resultado es un modelo que confirma el prejuicio de que solo funciona lo que cierra la venta, cuando lo que ha ocurrido es que se ha construido mal.
La regla práctica es sencilla: antes de añadir una variable de control, hay que preguntarse si podría estar causada por alguno de los medios del modelo. Si la respuesta es sí, no es una variable de control, es parte del efecto que estamos intentando medir.
La distinción entre confusor y mediador no siempre es limpia, y Meridian, la librería de MMM de Google, lo reconoce de forma explícita con una variable que recomienda incorporar: el volumen de búsquedas de la categoría y de marca (Google Query Volume).
El razonamiento es interesante porque funciona en dos direcciones. Para las campañas de search, el volumen de búsquedas es un confusor de libro: cuando hay más demanda, hay más búsquedas, y esas búsquedas generan a la vez más inversión en search y más ventas. Sin esa variable, el canal de búsqueda se apunta el mérito de una demanda que ya existía. Es, de hecho, una de las formas más habituales de sobrevalorar el search de marca.
Pero para el resto de canales, esa misma variable es un mediador: la programática, el vídeo o la televisión generan búsquedas, así que parte de su efecto viaja precisamente por ahí. Incluir el volumen de búsquedas les resta contribución.
Como el modelo es uno solo, hay que elegir un supuesto. La recomendación de Meridian es tratarlo como confusor e incluirlo, asumiendo que el sesgo que corrige en search pesa más que el que introduce en el resto, aunque reconociendo que la decisión depende del caso. Nos parece un buen ejemplo de que estas decisiones no son automáticas: son supuestos explícitos sobre cómo funciona el negocio, y conviene documentarlos, porque cambian los resultados.
Si te interesa conocer las variables de control que ofrece Google sobre tu negocio (GQV), puedes solicitarlas en la plataforma de datos de MMM de Google.
Conclusiones
Un Modelo de Marketing Mix no es tan bueno como su algoritmo, sino como las variables que lo alimentan. Y a lo largo de este artículo hemos visto que elegirlas no consiste en acumular todos los datos disponibles, sino en entender qué papel juega cada uno dentro del modelo.
Los cuatro bloques cumplen funciones distintas. Los medios de pago son las variables que queremos optimizar y las únicas de las que obtenemos un retorno, al tener inversión asociada. Los medios orgánicos entran con la misma mecánica (exposición, adstock y saturación) y nos dan su contribución, aunque no su ROI. Las acciones no publicitarias recogen decisiones de negocio que mueven las ventas tanto o más que la publicidad: precio, promociones, lanzamientos. Y las variables de control no se incluyen para medirlas, sino para que el contexto no se confunda con el mérito de los medios.
Si hay una idea que conviene llevarse, es la que abría el artículo: lo que no entra en el modelo no desaparece, se reparte entre lo que sí está. Un descuento que no se declara se convierte en eficacia publicitaria. Una estacionalidad que no se controla se convierte en retorno de los canales que invierten en esas fechas. Y, en sentido contrario, un mediador incluido por error le resta a un canal una parte de su efecto real.
Este último punto merece una mención final, porque afecta de lleno a la publicidad programática y al resto de medios de generación de demanda. Son canales que actúan precisamente a través de mediadores: generan notoriedad, búsquedas y visitas que después se convierten en venta por otros caminos. Un modelo mal especificado los infravalora de forma sistemática y acaba confirmando la vieja idea de que solo funciona lo que cierra la venta. No es un hallazgo del modelo: es una consecuencia de cómo se construyó.
Con este artículo cerramos los fundamentos del MMM que hemos ido desgranando en la serie: el adstock, la saturación, la separación entre baseline e incremental y, ahora, las variables que componen el modelo. En el próximo paso veremos cómo se ensambla todo ello en un modelo completo y qué preguntas permite responder.